La atribución cookieless funciona reemplazando los rastros de cookies de terceros con identificadores first-party, recolección de eventos server-side y modelado estadístico. En lugar de seguir a una persona por la web abierta, cose datos que recolectas directamente, como click IDs, logins y registros del CRM, y luego llena los huecos con métodos como el marketing mix modeling y las pruebas de incrementalidad. El resultado es una medición que sigue funcionando mientras los navegadores y los reguladores cierran el tracking entre sitios.
Por qué las cookies de terceros dejaron de ser confiables
Las cookies de terceros permitían que una plataforma de anuncios reconociera el mismo navegador en el sitio de un publisher y otra vez en tu página de checkout, que es como funcionaba la atribución clásica entre sitios. Safari y Firefox ahora las bloquean por defecto, Chrome las restringió con fuerza, y las leyes de consentimiento hacen que muchos usuarios nunca las acepten en primer lugar. Lo que queda es una muestra cada vez más pequeña y menos representativa.
El efecto práctico es que la atribución basada en pixels ahora ve solo una porción de los journeys reales. Las conversiones reportadas por plataforma a menudo no coinciden con los ingresos del backend, y sumar conversiones entre canales suele producir un número mayor al que tu tienda realmente registró, porque cada plataforma cuenta la misma venta de forma independiente. La atribución cookieless existe para reconstruir la medición sobre una base que no se degrada con cada versión del navegador.
Los bloques de construcción del tracking cookieless
La atribución cookieless no es una sola tecnología sino un stack de técnicas, cada una recupera parte de la señal perdida.
- Identificadores first-party. Emails, logins de cuenta y customer IDs recolectados con consentimiento en tus propias propiedades. Persisten mucho más que cualquier cookie y son tuyos.
- Click IDs y UTMs. Parámetros como gclid o una taxonomía de UTM disciplinada viajan con el clic mismo, así que sobreviven aunque las cookies no lo hagan, siempre que tu tagging sea consistente.
- Recolección de eventos server-side. Enviar los eventos de conversión desde tu servidor en lugar del navegador evita los bloqueadores de anuncios y las cookies de vida corta, y te permite adjuntar identificadores hasheados para mejores tasas de match.
- Conversiones modeladas. Estimaciones estadísticas que rellenan los journeys que no se pudieron observar directamente, algo que toda plataforma grande ya aplica a su propio reporte.
Dónde termina el tracking determinístico y empieza el modelado
El match determinístico responde la pregunta directamente cuando el mismo identificador aparece tanto en el clic como en la conversión. Eso cubre razonablemente bien a los usuarios logueados y los journeys en un mismo dispositivo, y es la columna vertebral del multi-touch attribution construido sobre datos first-party. Es preciso donde aplica, pero solo aplica a la porción de tráfico que realmente puedes identificar.
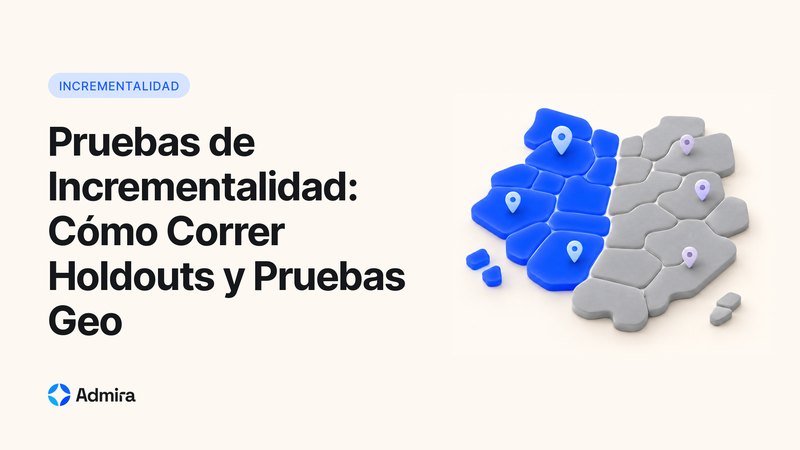
Todo lo demás requiere inferencia. El marketing mix modeling lee la relación entre gasto y resultados a partir de datos de series de tiempo agregadas, y no necesita ningún tracking a nivel de usuario, por eso funciona a cualquier tasa de consentimiento. Las pruebas de incrementalidad, como los geo holdouts, miden el lift causal directamente comparando regiones tratadas y no tratadas. Los equipos maduros triangulan las tres, usando cada método para verificar a los otros en lugar de confiar en un solo número. Cuando la atribución determinística, el MMM y un geo test coinciden a grandes rasgos, puedes actuar con confianza; cuando divergen, el desacuerdo mismo te dice dónde tu medición necesita trabajo.
Cómo se compara cookieless con la atribución basada en cookies
Puestas lado a lado, las diferencias favorecen a la medición cookieless en cada dimensión que importa con el tiempo.
| Dimensión | Tracking con cookies de terceros | Atribución cookieless |
|---|---|---|
| Cobertura | Se reduce a medida que los navegadores bloquean cookies | Estable, basada en datos que posees |
| Riesgo de privacidad | Alto, cada vez menos conforme | Bajo cuando el consentimiento se maneja bien |
| Granularidad | A nivel de usuario, cuando funciona | Mezcla de nivel de usuario y modelado |
| Durabilidad | Se degrada con cada versión del navegador | Mejora conforme crecen tus datos first-party |
La única columna donde las cookies de terceros aún se ven mejor es la granularidad pura, pero esa granularidad es cada vez más ilusoria: describe una porción más pequeña y sesgada de tu audiencia cada trimestre, así que el detalle de apariencia precisa se apoya sobre una base que se encoge.
Cómo empezar
Construir un stack cookieless es una secuencia de movimientos concretos, no un solo interruptor que activar.
- Audita dónde ocurren realmente las conversiones y qué identificadores existen en cada punto, para conocer tu cobertura determinística.
- Impón una convención estricta de UTM y click ID en cada canal, porque el tagging inconsistente rompe en silencio la atribución first-party.
- Mueve la recolección de conversiones a server-side y conecta las conversion APIs de plataforma para recuperar eventos bloqueados y subir las tasas de match.
- Agrega marketing mix modeling para las preguntas de presupuesto y corre lift tests periódicos para calibrar todo lo demás.
Las herramientas difieren en su énfasis aquí. Triple Whale y Northbeam se enfocan en enfoques de pixel-más-modelado para ecommerce, mientras que Ruler y Dreamdata se inclinan por los journeys B2B emparejados con el CRM. Admira reúne tracking cookieless-first e integraciones first-party con atribución, MMM y lift testing en un solo stack de medición, con una sola fuente de verdad y sin puntos ciegos, en marcha en unas dos semanas y sin trabajo de ingeniería. Si quieres una medición que sobreviva a la próxima actualización del navegador, agenda una demo y mira lo que tu marketing genera de verdad, no lo que cada plataforma modela para sí misma.
Preguntas frecuentes
¿La atribución cookieless funciona cuando los usuarios rechazan el consentimiento?
El tracking a nivel individual no, y ninguna herramienta conforme puede cambiar eso. Pero los métodos agregados como el marketing mix modeling y los geo lift tests funcionan sin importar las tasas de consentimiento, porque nunca dependen de identificar individuos. Ese es el núcleo de un stack cookieless durable: la atribución determinística mide con precisión la porción con consentimiento y logueada, mientras el modelado y los experimentos cubren al resto a nivel agregado sin tocar datos personales.
¿El browser fingerprinting es una técnica cookieless legítima?
No. El fingerprinting identifica usuarios sin consentimiento, los reguladores lo tratan como cualquier otro tracking, y los navegadores lo combaten activamente con defensas anti-fingerprinting. Construir medición sobre fingerprinting significa reconstruir de nuevo en un par de años cuando la próxima actualización del navegador lo rompa, cargando riesgo de cumplimiento todo el tiempo. La atribución cookieless durable se construye sobre datos first-party con consentimiento y modelado, no sobre re-identificar personas de forma encubierta.
¿Puedo seguir usando los reportes de last-click de las plataformas?
Sí, como señales direccionales para optimizar creativos y campañas dentro de un solo canal. No son una base justa para decisiones de presupuesto cross-channel, porque cada plataforma modela y reclama conversiones de forma independiente, así que sus totales se solapan y suman más que tus ingresos reales. Úsalos para dirigir dentro de Meta o Google Ads, pero mueve la asignación de presupuesto a una medición deduplicada y basada en el backend que tú controles.
¿Qué tan precisa es la atribución cookieless frente al viejo mundo de cookies?
La atribución basada en cookies nunca fue tan precisa como parecía; simplemente reportaba números de apariencia exacta a partir de datos cada vez más incompletos. Un stack cookieless triangulado que combina atribución first-party, MMM y pruebas de incrementalidad suele ser más honesto, porque su incertidumbre es explícita y se valida con experimentos en lugar de esconderse tras un dashboard de apariencia segura. La precisión viene de que los métodos se verifican entre sí, no de un solo número.